오늘 못하면 내일도 못한다
-
![12. Clustering and Image Segmentation]()
12. Clustering and Image Segmentation
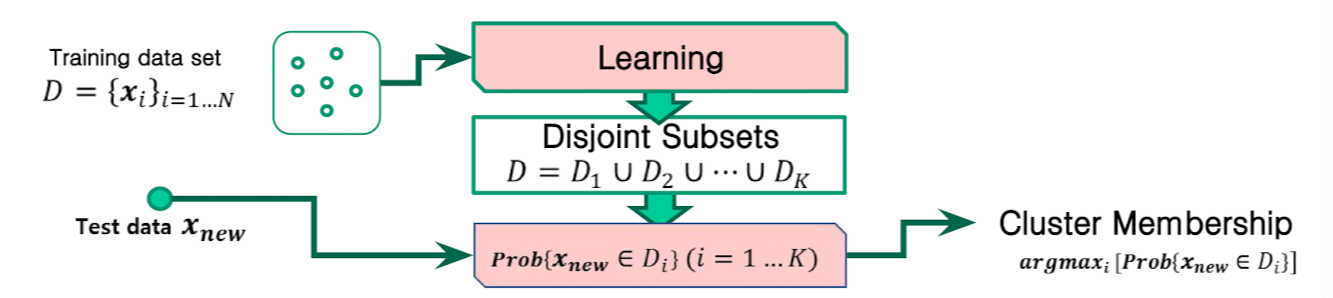
자신이 속한 집단이 어디인지 알고, 적합한 집단에 속해서 발전하는 것은 중요한 것이 아닐까 📌 clustering 유사한 성격을 가진 sample들을 묶어 그룹으로 형성하는 것 사전에 label이 주어지지 않는 unsupervised learning(비지도 학습)이다(classification은 data와 label을 같이주는 supervised learning이다) e.g.) data grouping, image segmentation method k-means, agglomerative Hierarchical Clustering, Mean Shift 📌 clustering : Task Definition training data set을 통해서 학습된 모델은 test data(new data)가 들어..
-
22. Generative Adversarial Network (GAN)
📌 GAN concept 이 경쟁이 그들을 우수하게 만들 것이라는 희망으로 신경망을 서로 경쟁하게 만든다. generator는 training data와 비슷한 data를 생성하려하고, discriminator는 진짜와 가짜를 구분하려 한다 생성적 적대 신경망, adversarial이 중요, 서로 발전한다 AE : input과 비슷한 output을 만들어내는 역할 Generator VAE의 decoder와 비슷한 모양이다 처음에는 랜덤한 pixel 값으로 채워진 가짜 이미지로 시작한다 descriminator의 판별 결과에 따라 지속적으로 업데이트 점차 원하는 이미지를 만들어간다 Discriminator regular binary classifier와 비슷한 모양이다 Generator에서 넘어온 이미지가..
-
![21. RNN Part II(Code) & Autoencoder]()
21. RNN Part II(Code) & Autoencoder
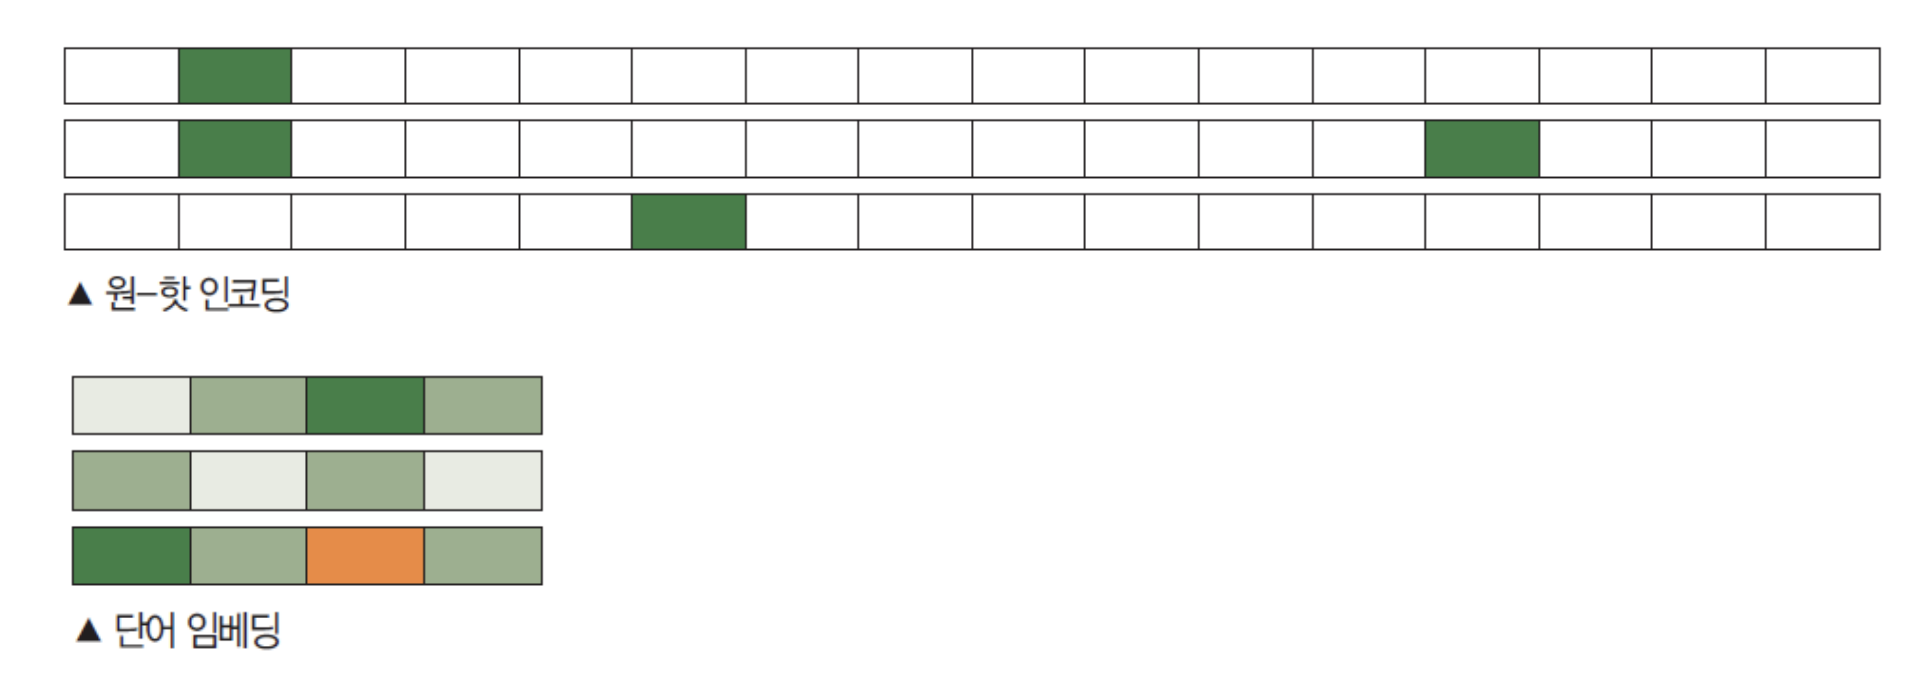
📌 자연어 처리 토큰화(Tokenization) : 텍스트를 단어 기준으로 잘게 자르는 것 from tensorflow.keras.preprocessing.text import Tokenizer token = Tokenizer() token.fit_on_texts(단어 배열) 단어의 one-hot encoding (1이 몇 번째 위치인지만 찾으면 되기에 속도가 빠르다) 하지만 단어의 종류가 많아진다면 one-hot encoding에서 벡터의 길이가 너무 길어진다는 단점이 있다 공간적 낭비를 해결하기 위해 단어 임베딩(word embedding)을 사용한다 📌 문장의 의미 파악하기 딥러닝은 단어를 그대로 사용하지 않고, 숫자로 변환한 다음 학습할 수 있다. 모든 단어를 다 사용하는 것은 비효율적이므로 빈도..
-
![20. RNN]()
20. RNN
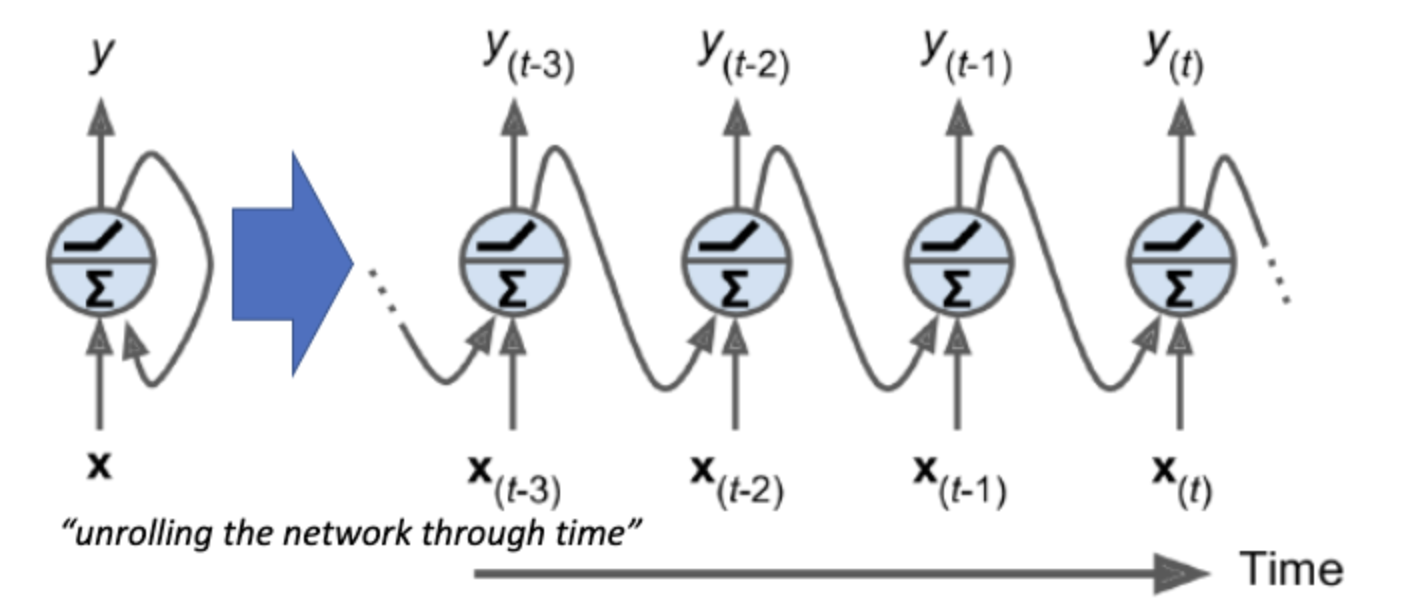
📌 Time series data dynamic data 가변 길이 sequential data 📌 Recurrent Neurons MLP, CNN : Feedforward NN RNN : backward connection RNN은 input을 받으면 output을 만들어내고, 그 output을 다시 넣는다 📌 Recurrent Neurons 시간 $t$일 때, recurrent neuron은 2개의 input을 받는다 $x(t)$ $y(t-1)$ : 이전 시간의 output $y(t)=\theta(W_x^t x(t)+W_y^T y(t-1) +b) $. theta는 activation function 노드는 1개이지만, 이해하기 위해서 펼쳐놓은 것 input, output의 개수는 여러 개가 될 수 있..
-
![19. Famous CNN architecture - Part 2]()
19. Famous CNN architecture - Part 2
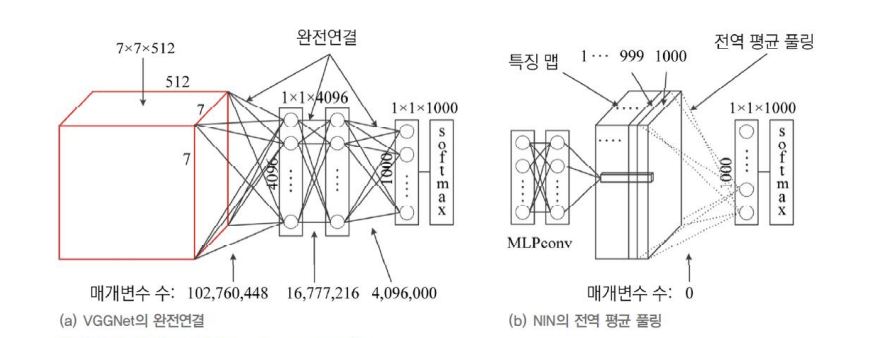
📌 Network In Network이 사용하는 전역 평균 풀링 VGGNet의 완전연결은 overfitting의 원인이다 Residual Learning 📌 ResNet key : skipping connections 더 적은 parameter로 더 deep한 network model을 만든다 deep network를 훈련시킬 수 있는 핵심 요소는 skip connection -> 어떤 layer에 주입되는 신호를 상위 층의 출력에 더 해준다 본래 신경망을 훈련시킬 때는 목적함수 $h(x)$를 모델링하는 것이 목표이다 ResNet은 input x를 출력에 더하여 네트워크 $h(x)$ 대신 $f(x)=h(x)-x$를 학습하게 만든다 -> skip connection이 존재할 때 네트워크를 초기화하면 네트워..